现在很多足球爱好者看球聊球都不再只靠经验直觉,足球分析的大数据应用:精准预测比赛已经从专业俱乐部的内部工具下沉到普通球迷也能上手的实用方法,不少人靠掌握正确的数据筛选逻辑,避开了过往凭印象猜胜负的常见误区,甚至能在观赛之余对比赛走势做出更贴合实际的判断。
别把冗余数据当核心参考指标
很多刚接触足球大数据分析的用户,一上来就搜两队的历史交锋总战绩,甚至把三五年前的冷门对局数据也纳入参考,最后得出的结论往往和实际走势偏差极大。
掌握正确的足球大数据筛选逻辑,就能避开经验预判的误区,更贴合实际地判断赛事走势
实际上有效数据的筛选边界基本控制在最近12个月的对局范畴,开云尤其是同赛事体系下的交手记录,跨赛季的低级别友谊赛数据完全可以直接剔除,这类样本的参考价值几乎为零。如果两支球队中间间隔两年没有正式交手记录,之前的交锋数据只能作为趣味参考,完全不能纳入胜负预测的权重计算里。
动态变量数据比静态排名权重更高
不少人预测比赛第一反应是看联赛积分榜的位次,开云体育觉得排名高的队伍赢面就大,这其实是忽略了大数据体系里的动态变量维度。
比如某支队伍最近三轮联赛连续遭遇点球误判、核心前锋吃到红牌停赛、连续一周双赛导致全队跑动距离比赛季均值低12%,这些动态数据的参考权重,远高于两队在积分榜上差出的三五个位次。
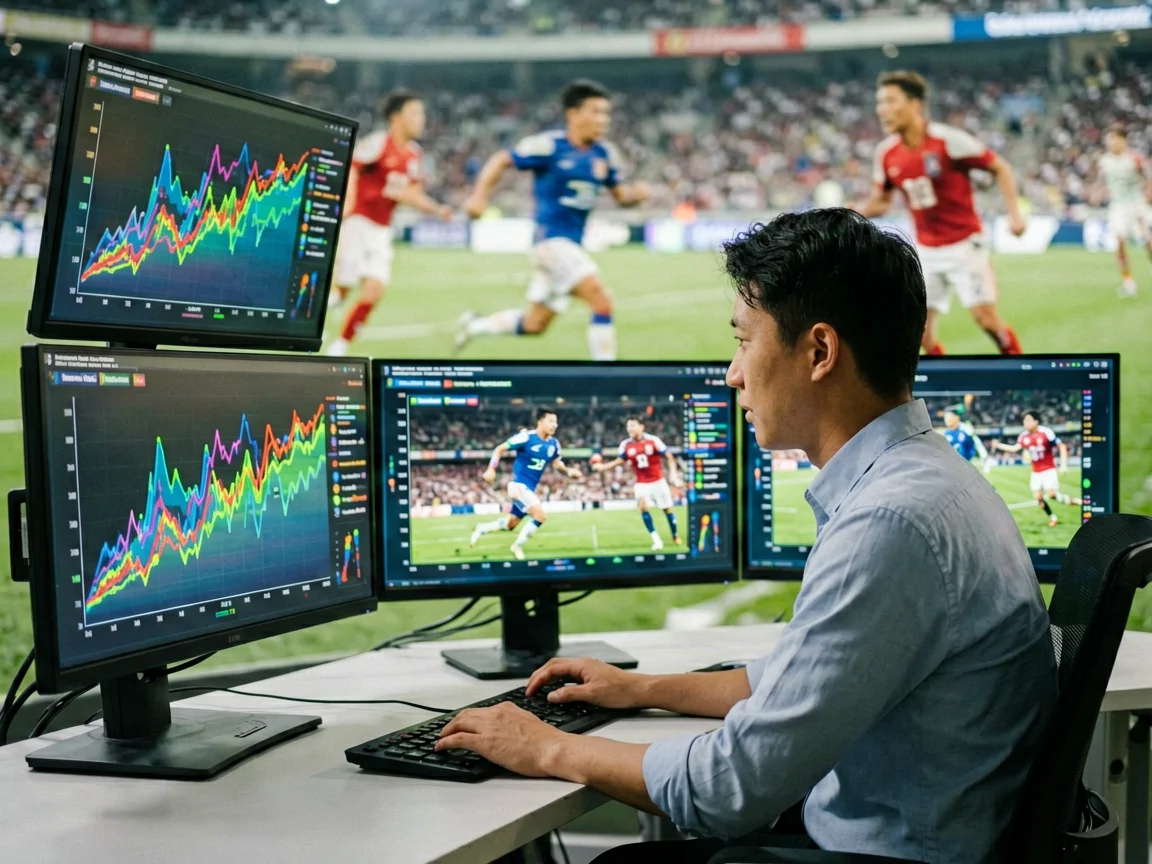
现在不少成熟的足球数据平台已经能实时同步全队的疲劳值、关键球员的伤病恢复进度、甚至赛前24小时的训练场对抗强度数据,把这些变量纳入分析体系,预测的准确率能比只看排名高出至少三成。
攻防两端的细节数据藏着走势伏笔
很多球迷看比赛只会数最终的射门数,却很少拆解大数据里的预期进球、禁区内触球次数、边路传中到位率这些细分指标,恰恰是这些细节能提前预判比赛的潜在走向。
比如某支队伍全场比赛的预期进球数达到2.7,却因为对方门将的超神发挥和门柱阻挡迟迟没能破门,这类对局后续的进球爆发概率,远高于两队都只有0.3预期进球的沉闷局面,哪怕当下比分还是0比0,也能大概率判断后续会出现进球。
还有不少大数据模型会统计球队在比分领先、落后、平局三种状态下的战术倾向,比如某支队伍在客场领先一球之后,后续比赛的平均防守收缩幅度会提升40%,这类特性数据能帮你避开很多“看似强队压着打却迟迟不进球”的坑。
避开大数据应用的常见认知误区
现在网上有不少打着大数据旗号的所谓预测公式,号称只要套入几个固定数值就能100%猜对赛果,本质上都是对足球分析的大数据应用:精准预测比赛的误解。
足球赛事本身就存在不可避免的随机性,裁判的瞬间判罚、球员的临场灵光一现,都是现有数据模型没办法完全覆盖的变量,合理的大数据应用是把预测准确率提升到65%到75%的区间,而不是追求所谓的百分百命中。
普通爱好者在使用大数据工具的时候,也不要完全脱离对赛事基本背景的了解,比如某支队伍近期已经锁定联赛冠军,接下来的联赛主动轮换大半主力,这类非竞技层面的信息,也要和数据结果结合起来交叉验证,才能得出最贴合实际的走势判断。慢慢摸索出适合自己的数据筛选逻辑之后,你对比赛的理解维度也会比之前只看球星名气、过往印象的阶段高出不少。